2020年3月28日土曜日

Fedora 31でTensorflow 1.15.2(CUDA10.2 cuDNN7.6.5)をビルドする

目的


前回のブログにつづき、TensorFlow 1.15.2をソースビルドする。1.x系と2.x系は両方あった方がよい。Dockerを使えばよいのだが、簡単に使える方がよいのでビルドする。


環境


前回と同様である。
  • Fedora 31 x86_64
  • python 3.7.6(virtualenv)
  • CUDA 10.2 + cuDNN 7.6.5
  • CPU AMD Ryzen 7 1700
  • GPU GeForce GTX 1070


事前準備


こちらも前回のブログと同様なので割愛。
詳細は、こちらを参照。ただし、Bazelのバージョンは0.26.1を使用する。


Tensorflowのビルド


さて、本題。TensorFlow 1.15.2をビルドする。1.x系の注意事項。

virtualenvの設定


ビルド


ソースを展開後、third_party/nccl/build_defs.bzl.tpl の116行目を削除する。これでCUDA 10.2 + cuDNN 7.6.5でのビルドができる。


ビルドを行う。途中でsys_gettidの問題でエラーとなる。
なお、/home/xxx/.cache/bazel/_bazel_xxx/aca0f394050ca263374306622f61644f のパスは、bazelのキャッシュであり毎回変わるので注意。


ビルドエラーが発生後、該当の external/grpc/src/core/lib/gpr/log_linux.cc を修正する。"gettid"を "sys_gettid"に置き換えて競合しないようにする。

ビルド完了後、pipパッケージを作成して、インストールする。


インストール確認


  • tf.__version__が1.15.2であること。
  • GPUデバイスを認識していること。

  • OK!

    Fedora 31でTensorflow 2.2-rc1(CUDA10.2 cuDNN7.6.5)をビルドする

    目的


    Tensorflowの2.2-rc1をFedora 30でソースビルドする。
    2.2の正式版リリースに向けての準備と備忘録。


    環境


    • Fedora 31 x86_64
    • python 3.7.6(virtualenv)
    • CUDA 10.2 + cuDNN 7.6.5
    • CPU AMD Ryzen 7 1700
    • GPU GeForce GTX 1070


    事前の準備


    GCC8のビルド


    前回の記事と同様、CUDA 10.2がサポートするGCCは8で、Fedora 31のGCC9ではビルドができない。このため、まずはGCC8のビルドを行う。
    GCCのビルドについては、以前の記事を参照。


    GCC8.4のソースダウンロード&ビルド


    以下でビルドを行う。


    specsファイルの作成


    コンパイルしたGCC7でビルドした際に、適切な動的リンクライブラリ(libstdc++.so)がリンクされるようにSPECEファイルを修正する。


    Environment Modulesの設定


    GCC8をEnvironment Modulesで切り替えられるようにする。/etc/modulefiles 配下に、gcc8xのファイルを作成する。
    ※筆者の環境にはソースビルドしたGCC5、GCC7がある。


    Bazelのビルド


    Bazelをソースビルドする(リポジトリのバージョンだとTensorflowが期待するバージョンと一致しないことがあるため)。2.2-rc1はBazel2.0.0が必要なため、ソースビルドした。

    公式のソースビルド方法はここを参照。手順どおりであり詳細の説明は割愛。


    CUDA、cuDNNのインストール


    CUDA: 10.2、cuDNN: 7.6.5をインストール。CUDAはRPM Fusion Howto/ CUDA を参考にインストールを行う。cuDNNはNVIDIAのダウンロードサイトからダウンロード、インストールを行う。


    Tensorflowのビルド


    さて、本題。TensorFlow 2.2-rc1をビルドする。


    virtualenvの設定


    まずはvirtualenv(virtualenvwapper)でTensorflow用の仮想Python環境を作成し、必要なモジュールをインストールする。


    ビルド


    Githubからソースを取得し、configureスクリプト実行し、ビルドを行う。

    • CUDAのサポートを有効とする。
    • Host compilerにGCC8のgccのパスを指定してあげる。
    • ビルドオプションには"--config=v2"と"--config=nonccl "(NCCLのライブラリをインストールしたがビルドエラーとなったので外す)を指定。
    • 日本語環境では依存関係のダウンロードで失敗したので、ビルド前に"LANG=C"で回避。

    なお、エラーは以下であった。


    インストール確認


    • tf.__version__が2.2-rc1であること。
    • GPUデバイスを認識していること。


    OK!

    2020年2月29日土曜日

    Jetson NanoでTF-TRTを試す(JetPack4.3)

    目的


    (ずいぶん前になるが)JetPack4.3がリリースされたので、TF-TRT(TensorFlow integration with TensorRT)を使ってFP16に最適化したモデルでの処理時間を計測する。


    動機


    前回のブログ「Jetson NanoでTF-TRTを試す(Object detection)」で、よくわからない事象として「SSDLite MobileNet v3 LargeのPre-trained Modelで検出ができない」をあげていた。これはtensorflow/modelsにIssueを報告していたのだけど、アップされたmodelに問題があったとのことで新しいmodelがPRされた(2020.2.29時点ではまだマージされていない)。

    問題が解決したのと、JetPackがアップデートされたので、再度、処理時間を計測しようと思った。


    まとめ


    • SSDLite MobileNet v3 large / smallはJetpack 4.2 + TF1.14と比べ処理時間が遅くなっている。
    • MobileNet v3以外のDetection model(v1, v2など)は、NonMaxSupperssionをCPU実行に書き換えるとTF-TRT FP16のモデル変換に失敗する。
    • Classification model(MobileNet v1, v2)はJetPack 4.2 + TF1.14と比べ処理時間が若干だが早くなっている。

    早くなっているね!で終わると思っていたのだが、つぶやいたとおりいろいろとあった。


    環境


    今回、3つのバージョンで計測した。
    • JetPack 4.2.2 + TF1.14
      JetPack: 4.2.2 (r32.2.1)
      TensorRT: 5.1.6
      TensorFlow: 1.14.0+nv19.10
      Python: 3.6.9
    • JetPack4.2.2 + TF1.15
      JetPack: 4.2.2 (r32.2.1)
      TensorRT: 5.1.6
      TensorFlow: 1.15.0+nv19.11
      Python: 3.6.9
    • JetPack4.3 + TF1.15
      JetPack: 4.3 (r32.3.1)
      TensorRT: 6.0.1
      TensorFlow: 1.15.0+nv20.1
      Python: 3.6.9

    モデルの生成


    TF-TRT FP16 のモデル変換は前回と同様、本家よりForkしたリポジトリを使用する。


    なお、SSDLite MobileNet v3 large/smallのpre-trained modelのリンクは変更済みである。モデルの変換および、ベンチマークの際は、CUIモード&jetson_clocksで実行している。


    Detection modelのベンチマーク


    今回は対象を以下のモデルに絞って行った。
    • ssdlite_mobilenet_v2_coco
    • ssdlite_mobilenet_v3_small_coco
    • ssdlite_mobilenet_v3_large

    TF-TRT FP16への変換、計測方法は前回のブログと同様である。
     NonMaxSupperssion(NMS)をCPU実行に書き換えて、TF-TRT FP16に変換。変換後、ベンチマーク用のスクリプト(初回の推論を除く100回の平均)で計測した。

    JetPack4.2.2+TF1.15、JetPack4.3+TF1.15の場合、ssdlite_mobilenet_v2_coco モデルがモデル変換時に「Aborted (core dumped) 」となり失敗する。

    2020-02-19 18:42:53.932561: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1304] Created TensorFlow device (/job:localhost/replica:0/task:0/device:GPU:0 with 1208 MB memory) -> physical GPU (device: 0, name: NVIDIA Tegra X1, pci bus id: 0000:00:00.0, compute capability: 5.3)
    2020-02-19 18:43:21.378537: I tensorflow/compiler/tf2tensorrt/segment/segment.cc:460] There are 1379 ops of 31 different types in the graph that are not converted to TensorRT: Range, Sum, GreaterEqual, Where, Select, ConcatV2, Less, Fill, ExpandDims, Unpack, GatherV2, NoOp, TopKV2, Cast, Slice, Transpose, Pad, Placeholder, ResizeBilinear, Squeeze, Mul, Reshape, AddV2, Pack, Identity, NonMaxSuppressionV5, Shape, Greater, Sub, Minimum, StridedSlice, (For more information see https://docs.nvidia.com/deeplearning/frameworks/tf-trt-user-guide/index.html#supported-ops).
    2020-02-19 18:43:22.630756: I tensorflow/compiler/tf2tensorrt/convert/convert_graph.cc:633] Number of TensorRT candidate segments: 2
    2020-02-19 18:43:22.784932: F tensorflow/core/util/device_name_utils.cc:92] Check failed: IsJobName(job) 
    Aborted (core dumped)

    これは、この方のブログ「JetPack-4.3 for Jetson Nano」でも同様の事象が発生するとあり、NMSをCPU実行に書き換えることをやめると変換に成功するとあった(実際に成功する)。ssdlite_mobilenet_v3は変換に成功するため、単純にNMSのCPU実行の書き換えが問題でないと思われる。

    このため、NMSを書き換えない場合も計測した。


    NMSをCPU実行に書き換えた場合


    Detection model
    (force_nms_cpu=True)
    Inference [ms]
    JetPack4.2.2+TF1.14JetPack4.2.2+TF1.15JetPack4.3+
    TF1.15
    ssdlite_mobilenet_v2_coco_fp16.pb53.62--
    ssdlite_mobilenet_v3_small_coco_fp1648.8964.9259.13
    ssdlite_mobilenet_v3_large_coco_fp1666.0180.5073.45
    -: モデル変換時にAborted (core dumped) が発生


    NMSを書き換えない場合


    Detection model
    (force_nms_cpu=False)
    Inference [ms]
    JetPack4.2.2+TF1.14JetPack4.2.2+TF1.15JetPack4.3+
    TF1.15
    ssdlite_mobilenet_v2_coco_fp16.pb68.3978.2388.34
    ssdlite_mobilenet_v3_small_coco_fp1699.22110.26119.78
    ssdlite_mobilenet_v3_large_coco_fp16111.26120.45123.28


    ベンチマーク結果


    JetPack4.3 + TF1.15は
    • TF-TRT FP16 に変換できるモデルに限りがある。
      今のところはSSDLite MobileNet v3 small / large(SSDLite MobileNet EdgeTPU)が確認できている。
      (おそらく、モデルを学習した時のTensorFlowのバージョンが関係する?)
    • SSDLite MobileNet v3 small / largeは
      JetPack4.2.2 + TF1.14と比べ、推論の処理時間が遅くなっている。
      JetPack4.2.2 + TF1.15と比べ、推論の処理時間は早くなっている。
    • NMSのCPU実行への書き換えを行わなければモデルの変換に成功するが、推論時間は長くなってしまう(ためおすすめではない)。
    • (NMSになにかありそう???)

    Classification modelのベンチマーク


    こちらも、以下のモデルでベンチマークを行った。
    • mobilenet_v1_1.0_224
    • mobilenet_v2_1.0_224

    (以前のブログ「Jetson NanoでTF-TRTを試す(Image Classification)その2」)と同様、TF-TRT FP16に変換。変換後、ベンチマーク用のスクリプト(初回の推論を除く100回の平均)で計測した。

    こちらは、変換時に問題も発生することはなく、JetPack4.3 + TF1.15で処理時間が早くなっていることが確認できた。

    Classification model
    Inference [ms]
    JetPack4.2.2+TF1.14JetPack4.2.2+TF1.15JetPack4.3+
    TF1.15
    mobilenet_v1_1.0_22423.6822.7421.58
    mobilenet_v2_1.0_22427.4526.6924.95


    2020年2月9日日曜日

    Edge TPUをWindowsで動かす(Coral January 2020 Updates)

    目的


    Edge TPU Python APIをWindowsで動作させる。


    動機


    2020.1.29にCoral January 2020 Updatesがリリースされた。このリリースでWin, Macがサポートされた。このため、Windowsについて動作することを確認しようと思った。


    自分が作成したEdge TPU Python APIを使ったサンプルを動作させるところまで。


    Windows環境のセットアップ


    環境


    試した環境は以下の通り。
    • OS: Windows 10 Home, バージョン 2004, OSビルド 19041.21
    • CPU: AMD Ryzen 7 1700
    • メモリ: 16GB
    • Coral USB Accelerator


    セットアップ


    Python環境


    Python環境はAnaconda 2019.10(Python3.7)をインストールする。

    Anaconda Promptを立ち上げ、仮想環境を作成しておく。

    > conda create -n coral anaconda


    Edge TPU runtimeのインストール


    Install the Edge TPU runtime - On Windows を参考に、Edge TPU runtimeをインストールする。ダウンロードしたファイルを解凍後、edgetpu_runtimeフォルダ内にあるinstall.batを実行する。


    TensorFlow Lite interpreterのインストール


    TensorFlow - Python quickstartを参考に、TensorFlow Lite interpreterをインストールする。

    > pip install https://dl.google.com/coral/python/tflite_runtime-2.1.0-cp37-cp37m-win_amd64.whl

    これでTensorFlow Lite APIからEdge TPUを使うことが可能。Run a model using the TensorFlow Lite AP のサンプルが動作できる。

    [注意]
    TensorFlow Lite API の場合、Edge TPUをPCに接続していない場合、
    "Failed to load delegate from edgetpu.dll"
    のエラーとなる。一見、Edge TPU runtimeのインストールに失敗していそうに思えるので注意。


    Edge TPU Python APIのインストール


    Coral - Edge TPU Python API for Mac and Windows を参考に、Edge TPU Python API for Windowsをインストールする。

    > pip install https://dl.google.com/coral/edgetpu_api/edgetpu-2.13.0-cp37-cp37m-win_amd64.whl

    これでインストールは完了。


    動作確認


    以前、作成したサンプルはRaspberry Pi + PiCamera用であったので、OpenCVベースに変更したものを用意した。とりあえず、現時点はObject detectionのサンプルのみ。

    PCに接続できるカメラがないため、動画ファイル(スマホで撮影)入力。

    モデルはSSDLite MobileNet EdgeTPU。


    その他


    Edge TPU Compilerのバージョンアップ


    Coral January 2020 Updatesでは、Edge TPU Compilerもバージョンアップした(2.0.291256449)。今回のバージョンで少しはまった点について。

    SSDLite MobileNet EdgeTPU に含まれるTF-Liteモデル(Full integer quant model)をEdge TPU Compilerでコンパイルしたところ、推論実行時に
    "ValueError: Dectection model should have 4 output tensors!This model has 12."
    でエラーとなってしまった。

    前回のEdge TPU Compiler(2.0.267685300)では問題なく、モデルも変わってはいない。

    原因は、もともとのTF-Liteモデルが確かにoutputが12個あったので、Edge TPU Python APIが期待するoutputの個数ではなかったためである。

    通常、TF-Liteモデルを生成する際、tocoで4つのoutput_arraysを指定するはずだが、SSDLite MobileNet EdgeTPUのpre-trainedモデルには異なるoutputが指定されていたと思われる(おそらく、もともとはPixel4向けなのでpostprocessingが異なるのかもしれない)。なので、今回のバージョンアップでは正しくコンパイルできるようになった...ということかもしれない。

    SSDLite MobileNet EdgeTPUはcheckpointからexport、tocoで変換することで、Edge TPUで動作することは確認できた。

    (もとのSSDLite MobileNet EdgeTPUのTF-Liteモデルはどうやって使うのだろうか?)

    2020年2月2日日曜日

    TensorFlow Lite for microのHello worldサンプルをM5StickVで動かす(その2)

    前回


    前回のブログでは、TensorFlow Lite for microのサンプル(Hello world)をM5StickV向けにビルド、動作させるところまでを書いた。出力はコンソール出力だけで、M5StickVのLCDには何も表示しない。


    目的


    今回は、M5StickVのLCDに表示を行うところをメインにする。
    こんな感じである。


    参考


    LCDに表示するまでの道のり


    LCDに表示するにはHWの制御がかなり必要である。自前でやるのもよいが、今回はsipeedが提供するMaixPyに含まれるライブラリを使用することにする。

    前回のプロジェクトに追加・変更する方針とする。


    sipeed / MaixPyのMaixPyのSDK


    もともと、Micropython 用の環境であるが、SDKと利用して独自のcプロジェクトをビルドすることができる。


    ただ、C++はビルドできないため、SDKのみを利用することにした。

    components配下のSDKの部分を利用する。以下のフォルダを利用した。
    • boards
    • drivers
    • kendryte_sdk
    • utils


    sipeed/MaixPyのSDKをプロジェクトに追加


    プロジェクトに追加する。


    sipeed/MaixPyのSDKをC++から呼び出せるように変更


    sipeed/MaixPyのSDKはC++から呼び出すことを考慮していない箇所が多数ある。このため、使用する部分のヘッダを変更する。

    extern "C" の追加し、呼び出し可能とする。

    今回は以下のヘッダを修正。

    TensorFlow lite for microのソース変更


    以下の処理を追加する。
    • main.ccでLCDを含むHWの初期化
    • output_handler.ccで描画の更新


    HWの初期化


    src/micro/tensorflow/tensorflow/lite/micro/examples/hello_world/main.ccで行う。
    • HWの初期化を行う。
      m5stick_init()
      (BUTTON B長押しの電源OFFもできるようになったりする)
    • setup_lcd()でLCD初期化を行う。

    man.ccはこのような感じになる。


    出力値に応じた点の描画


    src/micro/tensorflow/tensorflow/lite/micro/examples/hello_world/output_handler.ccで行う。

    STM32F746の実装を参考。LCD出力用の関数をsipeed/MaixPyのSDKを使用する。ただ、元の実装では円を描画しているが、sipeed/MaixPyのSDKには用意されていない。今回は矩形描画で代替えした。

    使用した関数は以下。
    • lcd_get_width ... LCDの幅を取得
    • lcd_get_height ... LCDの高さを取得
    • lcd_clear ... LCDのクリア
    • lcd_fill_rectangle ... 矩形を描画

    output_handler.ccはこのような感じになる。


    最後に


    前回、今回とM5StickVでTensorFlow Lite for microのサンプルをビルドするやり方を記載した。M5StickVには6軸センサやカメラがあるので、他のサンプルも行けると思うのでチャレンジしてみたい。


    2020年1月19日日曜日

    TensorFlow Lite for microのHello worldサンプルをM5StickVで動かす(その1)

    更新


    LCDを表示するぶぶんを「その2」に記載した。


    なお、ここで説明した時のソースは以下のcommitとなる。


    目的


    TensorFlow Lite for microのサンプル(Hello world)をM5StickV向けにビルド、動作させる。今回は、サンプルをそのまま動作させて、シリアルで結果が得られるところまでを確認する。


    動機


    前回、前々回のブログでTensorFlow Lite for microをRISC-Vプロセッサ向けにビルド・Qemuで動作させることを試した。やっぱり、実際のモノ(マイコンとか、実機)で動かしてみたいと思った。そういえば、M5StickVのCPUはRISC-V 64 bitなので、もしかしたらうまくいくかもしれないと思い、試してみた。


    ビルドまでの道のり


    ここでは、前々回のブログで用いたリポジトリ(本家からのfork)を使う。このため、最新では異なることがあるので注意。

    ビルドできるまでのいろいろなことを記載する。


    コンパイラ


    M5StickV向けのコンパイラは、以下で公開しているものを使った。
    バージョンは、「v8.2.0-20190409」である。


    Kendryte K210 standalone SDK


    non OS向けのSDKが公開されている。
    リンカスクリプトやBSP、ドライバのSDKが付属し、cmakeを利用してビルドできる。このリポジトリのsrc配下にターゲットとなるソースを配置し、CMakeLists.txtを編集することで、目的のバイナリがビルドできる。


    kflash_gui


    M5StickVのバイナリ書き込みツール。
    (メインで使っている)Fedora 30ではうまく起動できなかったため、Windows版を利用する。


    TensorFlow Lite for microの構成


    ビルドに必要なソース・ヘッダファイルを確認した。ここでは、「hello world」サンプルをもとにする。

    Makefile


    大本のMakefileは以下。ビルド時にターゲットCPUとビルドするアプリケーション(プロジェクト)を指定する。
    前回指定したRISC-V 32bit、hello worldのサンプルの場合、この辺りも参照する。
    riscv32_mcu/Makefile.inc は、#33972 のRISC-Vターゲットでビルドが失敗する問題を解消するためである。これは、今時点(2020.1.19)で取り込まれていないため注意。


    3rd party ライブラリ


    TensorFlow以外のライブラリは以下を使用している。
    上記以外では、ターゲット固有のSDKやtoolchainであるため、ここでは省略。なお、gemmlowp、flatbuffersともヘッダーファイルだけを使用する。


    ファイル構成


    hello worldのビルドに必要なソース・ヘッダファイルの構成は以下。microがどのようなファイルを必要としているのか、見渡せるようにする。本体と比べれば、ファイル数は少ない。

        tensorflow
        ├ tensorflow
        |  ├ core
        |  |  └ public
        |  |      └ version.h
        |  └ lite
        |      ├ c
        |      |  ├ builtin_op_data.h
        |      |  ├ common.c
        |      |  └ common.h
        |      ├ core
        |      |  └ api
        |      |      ├ error_reporter.cc
        |      |      ├ error_reporter.h
        |      |      ├ flatbuffer_conversions.cc
        |      |      ├ flatbuffer_conversions.h
        |      |      ├ op_resolver.cc
        |      |      ├ op_resolver.h
        |      |      ├ tensor_utils.cc
        |      |      └ tensor_utils.h
        |      ├ kernels
        |      |  ├ internal
        |      |  |  ├ optimized
        |      |  |  |  └ neon_check.h
        |      |  |  ├ reference
        |      |  |  |  ├ integer_ops
        |      |  |  |  |  ├ add.h
        |      |  |  |  |  ├ conv.h
        |      |  |  |  |  ├ depthwise_conv.h
        |      |  |  |  |  ├ fully_connected.h
        |      |  |  |  |  ├ mul.h
        |      |  |  |  |  ├ pooling.h
        |      |  |  |  |  └ softmax.h
        |      |  |  |  ├ add.h
        |      |  |  |  ├ arg_min_max.h
        |      |  |  |  ├ binary_function.h
        |      |  |  |  ├ ceil.h
        |      |  |  |  ├ comparisons.h
        |      |  |  |  ├ concatenation.h
        |      |  |  |  ├ conv.h
        |      |  |  |  ├ depthwiseconv_float.h
        |      |  |  |  ├ depthwiseconv_uint8.h
        |      |  |  |  ├ dequantize.h
        |      |  |  |  ├ floor.h
        |      |  |  |  ├ fully_connected.h
        |      |  |  |  ├ logistic.h
        |      |  |  |  ├ maximum_minimum.h
        |      |  |  |  ├ mul.h
        |      |  |  |  ├ neg.h
        |      |  |  |  ├ pad.h
        |      |  |  |  ├ pooling.h
        |      |  |  |  ├ prelu.h
        |      |  |  |  ├ process_broadcast_shapes.h
        |      |  |  |  ├ quantize.h
        |      |  |  |  ├ round.h
        |      |  |  |  ├ softmax.h
        |      |  |  |  └ strided_slice.h
        |      |  |  ├ common.h
        |      |  |  ├ compatibility.h
        |      |  |  ├ quantization_util.cc
        |      |  |  ├ quantization_util.h
        |      |  |  ├ round.h
        |      |  |  ├ scoped_profiling_label_wrapper.h
        |      |  |  ├ strided_slice_logic.h
        |      |  |  ├ tensor.h
        |      |  |  ├ tensor_ctypes.h
        |      |  |  └ types.h
        |      |  ├ kernel_util.cc
        |      |  ├ kernel_util.h
        |      |  ├ op_macros.h
        |      |  └ padding.h
        |      ├ micro
        |      |  ├ examples
        |      |  |  └ hello_world
        |      |  |      ├ constants.cc
        |      |  |      ├ constants.h
        |      |  |      ├ main.cc
        |      |  |      ├ main_functions.cc
        |      |  |      ├ main_functions.h
        |      |  |      ├ output_handler.cc
        |      |  |      ├ output_handler.h
        |      |  |      ├ sine_model_data.cc
        |      |  |      └ sine_model_data.h
        |      |  ├ kernels
        |      |  |  ├ activations.cc
        |      |  |  ├ activation_utils.h
        |      |  |  ├ add.cc
        |      |  |  ├ all_ops_resolver.cc
        |      |  |  ├ all_ops_resolver.h
        |      |  |  ├ arg_min_max.cc
        |      |  |  ├ ceil.cc
        |      |  |  ├ comparisons.cc
        |      |  |  ├ concatenation.cc
        |      |  |  ├ conv.cc
        |      |  |  ├ depthwise_conv.cc
        |      |  |  ├ dequantize.cc
        |      |  |  ├ elementwise.cc
        |      |  |  ├ floor.cc
        |      |  |  ├ fully_connected.cc
        |      |  |  ├ logical.cc
        |      |  |  ├ logistic.cc
        |      |  |  ├ maximum_minimum.cc
        |      |  |  ├ micro_ops.h
        |      |  |  ├ micro_utils.h
        |      |  |  ├ mul.cc
        |      |  |  ├ neg.cc
        |      |  |  ├ pack.cc
        |      |  |  ├ pad.cc
        |      |  |  ├ pooling.cc
        |      |  |  ├ prelu.cc
        |      |  |  ├ quantize.cc
        |      |  |  ├ reshape.cc
        |      |  |  ├ round.cc
        |      |  |  ├ softmax.cc
        |      |  |  ├ split.cc
        |      |  |  ├ strided_slice.cc
        |      |  |  ├ svdf.cc
        |      |  |  └ unpack.cc
        |      |  ├ memory_planner
        |      |  |  ├ greedy_memory_planner.cc
        |      |  |  ├ greedy_memory_planner.h
        |      |  |  ├ linear_memory_planner.cc
        |      |  |  ├ linear_memory_planner.h
        |      |  |  └ memory_planner.h
        |      |  ├ riscv64_mcu
        |      |  |  ├ debug_log.cc
        |      |  |  └ README.md
        |      |  ├ tools
        |      |  |  └ make
        |      |  |      └ downloads
        |      |  |          ├ flatbuffers
        |      |  |          |  ├ include
        |      |  |          |  |  └ flatbuffers
        |      |  |          |  |      ├ base.h
        |      |  |          |  |      ├ flatbuffers.h
        |      |  |          |  |      └ stl_emulation.h
        |      |  |          |  └ LICENSE.txt
        |      |  |          └ gemmlowp
        |      |  |              ├ fixedpoint
        |      |  |              |  ├ fixedpoint.h
        |      |  |              |  └ fixedpoint_sse.h
        |      |  |              ├ internal
        |      |  |              |  └ detect_platform.h
        |      |  |              └ LICENSE
        |      |  ├ compatibility.h
        |      |  ├ debug_log.h
        |      |  ├ debug_log_numbers.cc
        |      |  ├ debug_log_numbers.h
        |      |  ├ memory_helpers.cc
        |      |  ├ memory_helpers.h
        |      |  ├ micro_allocator.cc
        |      |  ├ micro_allocator.h
        |      |  ├ micro_error_reporter.cc
        |      |  ├ micro_error_reporter.h
        |      |  ├ micro_interpreter.cc
        |      |  ├ micro_interpreter.h
        |      |  ├ micro_mutable_op_resolver.cc
        |      |  ├ micro_mutable_op_resolver.h
        |      |  ├ micro_optional_debug_tools.cc
        |      |  ├ micro_optional_debug_tools.h
        |      |  ├ micro_utils.cc
        |      |  ├ micro_utils.h
        |      |  ├ simple_memory_allocator.cc
        |      |  ├ simple_memory_allocator.h
        |      |  ├ test_helpers.cc
        |      |  └ test_helpers.h
        |      ├ schema
        |      |  └ schema_generated.h
        |      ├ string_type.h
        |      ├ string_util.h
        |      ├ type_to_tflitetype.h
        |      └ version.h
        ├ AUTHORS
        └ LICENSE


    デバッグログの出力


    HWやtoolchain固有の部分であり、DebugLog関数を実装することになる。RISC-V向けには、RISC-V 32bitをそのまま流用することで、シリアルにログが出力される。


    ビルドプロジェクト


    今回は、TensorFlow Lite for microのMakefileを使用するのではなく、Kendryte K210 standalone SDKのcmakeを使ってのビルド方法にした(そのほうが楽そうだった)。

    ビルド用のプロジェクトは以下で公開している。


    TensorFlow Lite for microのhello worldで使用するソース・ヘッダファイルのみをsrc配下に格納する。
    ※tensorflowすべてのファイルを格納してしまうと、SDK内でヘッダファイルの競合が発生するため、必要なファイルのみとした。

    CMakeLists.txtには、必要なヘッダのパス、ソースファイルの一覧を記載する。また、前々回のブログでも記載した、std::roundの参照エラー(#35302)の回避のために、以下の定義を追加しておく。あと、Kendryte K210 standalone SDKが便利なマクロを用意してくれるので助かる。

    M5StickV向けのビルドで発生するビルドエラーの回避


    1か所、ビルドエラーが発生するためにソースを修正する。
    std::minの第二引数「(1ll << 31) - 1.0」がfloatであるといわれて、第一引数「beta * input_scale * (1 << (31 - input_integer_bits))」のdoubleと型が不一致だと怒られてしまう。第二引数「(1ll << 31) - 1.0」はdoubleではないのか?(しかも、前々回のブログではエラーとならなかった...)のでもしかしたら、toolchainによるものかも?

    とりあえず、doubleにキャストすることで回避する。


    ビルド


    kflash_guiが(自分の環境だと)Windowsでしか動かないのでWindows 10でビルドする。

    Windows版のCMakeをインストールする。

    Kendryte RISC-V GNU Compiler Toolchainをダウンロードして適当なディレクトリで展開する。

    PowerShellで操作。
    > git clone https://github.com/NobuoTsukamoto/m5stickv-tensorflow-lite-micro.git
    > $env:Path="\kendryte-toolchain\bin;C:\Program Files\CMake\bin;" + $env:Path
    > cd m5stickv-tensorflow-lite-micro\src\micro
    > mkdir build
    > cd build
    > cmake -G "MinGW Makefiles" ../../../..
    > make
    

    ビルド後、buildディレクトリに「micro」と「micro.bin」のファイルができる。
    「micro.bin」ファイルをkflash_guiでM5StickVに焼けばOK。


    結果


    Teratermで接続すると、シリアルにログが出力される。


    次回


    つぎは、M5StickVのLCDに結果表示するために行ったことを記載する。


    2020年1月4日土曜日

    TensorFlow lite for micro で RISC-Vターゲットのサンプルをqemuで動かす

    目的


    前回のブログ「TensorFlow lite for micro で RISC-Vターゲットのサンプルをビルドする」で生成した、Hello worldのバイナリを実行する。
    ただ、実機("Hifive1" SiFive FE310 development board)は持っていないため、qemuで動作させる。


    qemuでの実行


    qemuの準備


    RISC-Vターゲットのqemuを準備する。Fedora 31にはパッケージ(qemu-system-riscv 4.1.1)が存在するが、今回はver.4.2をソースビルドする。

    ソースビルド


    依存関係のインストール。追加で必要になったのは以下(その他はTensorFlowなどのビルドで入っているかも?)。

    $ sudo dnf install glib2-devel pixman-devel

    ソースファイルをダウンロード。

    $ wget https://download.qemu.org/qemu-4.2.0.tar.xz
    $ tar xf qemu-4.2.0.tar.xz
    $ cd qemu-4.2.0/

    configure, makeを行う。ターゲットはriscv32-softmmuのみでよいはず。後のことも考えて、その他のRISC-Vターゲットもビルドする。

    $ ./configure --target-list=riscv64-softmmu,riscv32-softmmu,riscv64-linux-user,riscv32-linux-user
    $ make -j$(nproc)
    $ sudo make install


    バイナリのqemuでの実行


    前回のブログで作成したTensorFlow lite for microのRISC-Vターゲットのバイナリ(Hello worldのサンプル)を実行する。
    オプションの指定は以下。
    • machineオプション: sifive_e
    • kernelオプション: 作成したELFファイル
      tensorflow/tensorflow/lite/micro/tools/make/gen/riscv32_mcu_riscv32_mcu/bin/hello_world

    実行。

    $ qemu-system-riscv32 -nographic -machine sifive_e -kernel tensorflow/tensorflow/lite/micro/tools/make/gen/riscv32_mcu_riscv32_mcu/bin/hello_worl

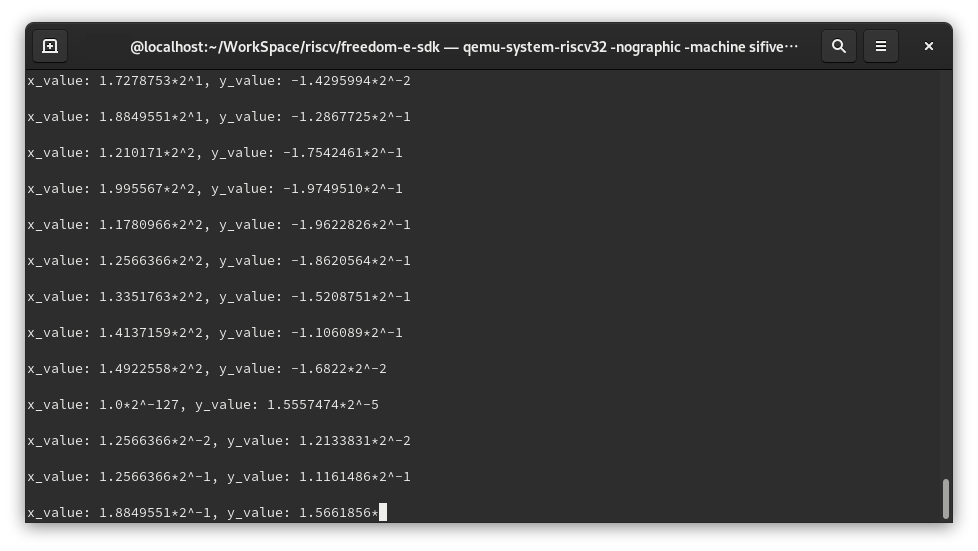
    コンソールにログが出力される。Hello worldのサンプルは正弦波を出力するモデルである。x_value, y_valueにそれなりの値が永遠と出力される。